← wa6snクロスアカウントな RDS Snapshot Export によるカジュアルなデータ集約の仕組み#

クロスアカウントな RDS Snapshot Export による

カジュアルなデータ集約の仕組み

2025/01/24 Finatext TechNight #4

$ whoami

@wa6sn(わらしな)

  • CCoE っぽいこと、データ基盤、セキュリティ、データベースなど

    • 社内 ISUCON 主催や AWS Gameday の企画、技術広報っぽいことなども
    • 最近の関心は、歴史的経緯により生まれた負債の解消
  • https://speakerdeck.com/wa6sn

まとめ

  • 十数の AWS アカウントに存在する RDS のデータを
    一箇所に集約してクエリをしたいという要件があった

  • 各プロダクト開発者との調整を極力少なくし、
    カジュアルに始めるためには RDS Snapshot Export が便利だった

  • 中小規模で複数のプロダクトがある、といったパターンでアリだと思う

背景(2021 年の実装当時)

  • 様々な領域で、複数のプロダクトを展開し、
    当時すでに 80 程度の AWS アカウントが存在した

  • 社内にデータ基盤の類が存在しなかった。プロダクト間の連携が前提となる
    アーキテクチャの一方、プロダクトをまたいだクエリを書くことが出来なかった

    • 主に "販売実績レポートの出力" のようなタスクにおいて、
      プロダクト間のデータ連携は温かみのある手渡しが多くあったのじゃ
  • 辛くなってきたのでデータ基盤(仮)を作ることにした

イマイチ伝わりづらいかもしれないが規模感

center

プロダクトに対して非侵襲な仕組みにしたい

  • なんせ対象のプロダクト・開発メンバーが異なる文脈で複数存在するので、
    リテラシ・採用技術・リリースサイクル・運用体制・etc もそれぞれ異なる
    • 「データは RDS に入っている」ぐらいの共通点はあった
  • DB の負荷に気を配りたくないし、ネットワークの疎通性とか気にしたくないし、受け入れ側開発者の実装タスクも減らしたい
    • データ基盤のありがたみをまだ実感していない組織に後付けで導入するので、
      実装コストは低ければ低いほどいい
    • リッチな仕組みはありがたみが理解されてから、としたい

選ばれたのは、RDS Snapshot Export でした

center

登場人物|RDS Snapshot Export

  • Amazon RDS の Amazon S3 への DB スナップショットデータのエクスポート
  • RDS(Aurora も含む)内のデータを Parquet という列志向のデータフォーマットに
    変換して、S3 バケットに Export してくれる機能
    • "S3 バケット" ゆえに、当然クロスアカウントに Export できる
  • RDS を使っていれば導入できて、特定のパラメータも、DB ユーザも必要ない
    • Snapshot から AWS 内部のインフラを使って Export しているので、
      本番 DB にトラフィックが流れないし、素朴に DB へ接続する種々の
      アーキテクチャに比べ、疎通性を気にする必要もない
  • "前回の Export からの差分だけを Export" のような器用なことは出来ず、
    選択したテーブルに対しては常に全量を Export することになる

登場人物|BigQuery Data Transfer Service

  • 今日は AWS ネタの日なので、詳細は割愛
  • BigQuery Data Transfer Service とは
  • 各種オブジェクトストレージなどから BigQuery に転送するマネージドサービス
  • S3 に置かれた Parquet 等のデータをほぼシームレスに BigQuery に取り込める
    • 細切れの Parquet ファイルからいい感じにテーブルに復元してくれる
      (AWS からの流入を狙っていると言わんばかりの手軽さ)
  • Parquet に変換されたデータを流し込むので、意外に転送料金は安い

登場人物|Lambda + Step Functions

  • それほど目新しいものではないと思うので、詳細は割愛
  • 「Export タスクを開始する」「Export タスクが終了していることを確認する」等の
    一連の処理を Lambda で実装し、Step Functions でまとめている
  • それほどデータ鮮度は要求されていないので、日次更新

(参考) Lambda + Step Functions のワークフロー

center

RDS Snapshot Export、ここが嬉しい

何よりプロダクト側の実装負担がほとんどない

  • RDS を使っていれば導入でき、スイッチ用の IAM Role(赤線部)だけ作れば OK
    • Policy には主に Snapshot 作成 + Export 実行 + S3 バケット操作に必要な権限を記述

center

RDS Snapshot Export の地味に便利な副産物

  • RDS Snapshot Export を実行すると、Export 先にはテーブルデータ以外に
    「テーブルメタデータ」としての json ファイル が副産物として置かれる
  • このファイルをちょっと整形して再利用することで、
    プロダクト側とコミュニケーションしやすくて便利(後述)

center

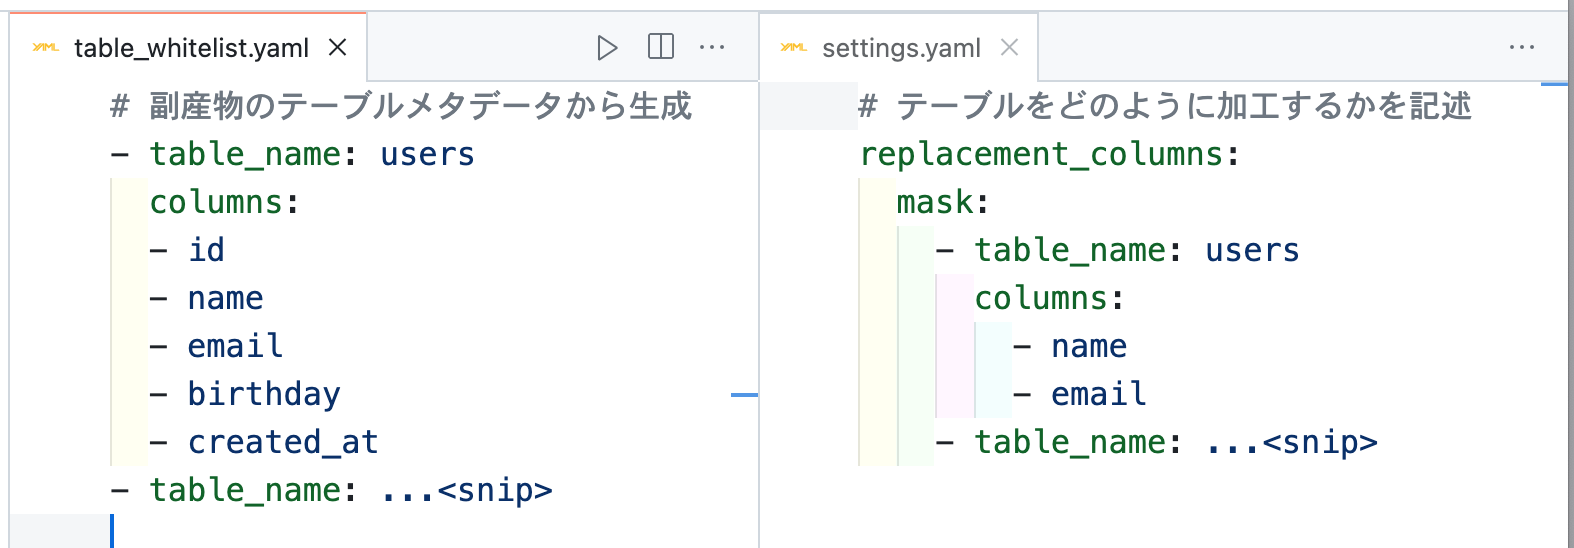
テーブルメタデータを介したデータ加工のすり合わせ

  • 前述の "副産物" 由来のファイルから生成した DDL から、各テーブル・カラムを
    どのように加工して利用者に見せるか、プロダクト開発者とすり合わせている
    • DDL は「開発者の確認済みテーブル」として、ある種ホワイトリストの役割も果たす
      • プロダクトで追加したカラムが、うっかりそのまま連携されるのを防ぐ

center

テーブルメタデータを介したデータ加工のイメージ

  • それぞれ DDL, 加工設定, SQL

center

CREATE OR REPLACE TABLE `warehouse.users` AS
SELECT `id`, '*' AS `name`, '*' AS `email`, `birthday`, `created_at`
FROM `datalake.users`
その後……

  • 現在はおよそ 20 数個の DB クラスタの統合が実現できている
    • 最大の DB で約 400 テーブル、一部の大きいテーブルには数億行ぐらいのレコード
    • それぞれ異なる AWS アカウント
  • プロダクト側の実装箇所・アーキテクチャによる制限がほとんどないのは便利
    • 「IAM Role + Policy を作ったら、データ基盤に連携された」
  • 運用当初(2022 年初頭)は Export タスクがスタックし続けるような障害が
    たまに発生していたが、現在はそんな障害は観測されずかなり安定している
    • AWS さんの地道な改善がありがたい
  • この仕組みで対応できない部分の隙間家具として、TROCCO® を使っている

最近の思い

  • なんやかんやで 3 年ぐらい使い続けてしまったが、そのうちデータ鮮度などの
    要求に応えるためのリアーキテクチャの機運があると思っている
  • データエンジニアリングに詳しいひとに加わってほしい(切実)